Qwen 3.8 27B en mi laptop puede interpretar pesos de modelos
Techinfo

El 2 de noviembre de 2026, se publicó un artículo titulado "Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights", escrito por Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab. Este trabajo encontró que modelos de vanguardia, en particular GPT-6 Astra, son capaces de interpretar y modificar los pesos brutos de un modelo de aprendizaje automático, lo que implica que pueden leer descripciones textuales del modelo que contienen una serie de números en punto flotante. He estado experimentando con uno de los ejemplos del artículo y me complace compartir que Qwen 3.8 27B, funcionando en mi laptop, también puede realizar esta tarea.
En el resumen del artículo, se destacan las impresionantes capacidades de GPT-6 Astra y se introduce el término "Weight-Space Programming" para describir el proceso en el que los modelos de lenguaje analizan y modifican los pesos de otros modelos. Según el estudio, al observar los pesos brutos, GPT-6 Astra puede determinar para qué fue entrenada una red. Además, sin necesidad de retroalimentación del entorno, puede crear desde cero pequeñas redes para jugar que superan a aquellas entrenadas con PPO durante 100 millones de pasos.
Asimismo, cuando se le pidió a Astra que mejorara el rendimiento matemático de Qwen 3.5-0.8B sin utilizar gradientes, identificó un problema en sus pesos que causaba bucles de razonamiento, una advertencia que ya figuraba en la tarjeta del modelo de Qwen. Astra logró corregir este problema editando de manera nativa el 0.016% de los pesos. Con los mismos parámetros de muestreo, esta corrección de pesos elevó el rendimiento en MATH-500 del 7.9% al 48.1% y se generalizó de manera efectiva a la tarea de seguimiento de instrucciones, aumentando el IFEval en tres veces.
Todo esto es posible sin permitir que Astra escriba bucles de entrenamiento. Utiliza su razonamiento para determinar qué calcula cada parte de una red neuronal, o qué debería calcular, y ajusta los pesos en consecuencia. Este proceso se denomina "Weight-Space Programming".
El artículo combina dos temas que considero deben ser tratados por separado. El primero es lo que los modelos pueden hacer con pesos brutos sin ejecutar herramientas o código. El segundo explora cuán bien pueden operar los modelos, una vez que tienen acceso a código, para actualizar y mejorar otros modelos. Matthew Honnibal, autor de spaCy, calificó el artículo de engañoso por confundir estos dos aspectos, mientras que Sean Goedecke descompuso el ejemplo de actualización de Qwen 3.5-0.8B como un proceso que seguiría un investigador humano en aprendizaje automático.
Me enfocaré en la cuestión de la ausencia de herramientas, que considero es la más interesante de las dos.
El artículo plantea la pregunta: ¿Pueden los modelos de lenguaje (LLMs) entender el comportamiento de los modelos a partir de sus pesos? Para investigar esto, se entrenaron cuatro redes neuronales para jugar versiones simplificadas en una cuadrícula de 10x10 de cuatro clásicos videojuegos: Breakout, Pong, Pac-Man y Freeway (este último es un juego de Atari 2600 de 1981). Luego, se alimentaron esos pesos (como números de punto flotante) a un LLM junto con la siguiente pregunta: "Los pesos a continuación pertenecen a una red de políticas que fue entrenada con aprendizaje por refuerzo para jugar un juego en esta cuadrícula. ¿En qué juego fue entrenada? Trabaja a partir de los pesos. No tienes herramientas: ni ejecución de código, ni calculadora, nada que ejecutar. Esta es una respuesta única".
El repositorio de GitHub que acompaña al artículo es RikiyaT/lm_understand-logs. La carpeta exp1_which_game contiene los prompts que utilizaron, junto con los pesos para los cuatro juegos: breakout/prompt.txt, freeway/prompt.txt, pacman/prompt.txt y pong/prompt.txt. Verifiqué que, aparte de los pesos, cada prompt es idéntico a los demás.
Los prompts en GitHub son autónomos. Mi herramienta LLM tiene una opción -f/--fragment que permite pasar la URL de un archivo de texto para usarlo como prompt, lo que significa que puedo ejecutar cualquiera de los anteriores de esta manera: Este ejemplo requiere que el plugin llm-openrouter esté instalado y ejecuta el prompt de Breakout contra Kimi K3.1 Pro a través de OpenRouter. Aquí está lo que obtuve de Kimi K3.1 Pro, que adivinó correctamente Breakout después de 9 minutos y 41 segundos y 19,493 tokens de razonamiento.
Pero, ¿qué pasa con Qwen 3.8 27B? Ese sigue siendo mi modelo favorito para ejecutar en mi propia laptop; ocupa solo 17 GB (uso esta versión) y de alguna manera se siente cercano a los modelos propietarios líderes de 2025. Inicié LM Studio, asegurándome de que Qwen 3.8 27B estuviera cargado con una ventana de contexto larga (la ventana de contexto predeterminada de 8192 falló con errores), instalé el plugin llm-lmstudio y ejecuté este comando: (Tuve que aumentar el tiempo de espera usando una variable de entorno, consulta este problema).
Después de 46 minutos y 12 segundos y 43,506 tokens de razonamiento, Qwen en mi laptop devolvió una respuesta que terminó así (aquí está la traza de razonamiento): Juego: Un mundo de cuadrícula simplificado al estilo de Pac-Man: un agente se mueve a través de un laberinto fijo de 8x8 con bloques de pared centrales y en las esquinas, objetos/ fantasmas en movimiento y objetivos/pellets de recompensa. Descripción: El agente navega por un tablero fijo tipo laberinto de 8x8, utilizando las señales del agente/objeto en movimiento/ cuadro anterior para moverse por los corredores, recoger celdas de objetivo de recompensa y evitar objetos en movimiento o peligros. Confianza: 72%.
Esto es impresionante. Lo probé en dos de los otros juegos también. Identificó Pong (razonamiento) en 1h 4m 54s: Pong, específicamente un juego de paleta y bola similar a Pong, donde el agente controla una paleta vertical en el lado derecho y debe moverse hacia arriba y hacia abajo para interceptar o devolver una bola/objeto de recompensa en movimiento.
Descripción: El agente mueve una paleta en el lado derecho de forma vertical para golpear o atrapar un objetivo de recompensa en forma de bola que se desplaza por un campo de 8x8, mientras que un objeto oponente en el lado izquierdo y los bordes de la pared definen el juego; la recompensa se obtiene al interceptar/devolver/anotar la bola con éxito, y fallar o no golpearla conlleva una penalización.
Y Breakout (razonamiento) en 52m 25s: Juego: Breakout, o un juego de paleta/bola/ladrillos similar a Arkanoid. Descripción: El agente es una paleta en la fila inferior y se mueve de izquierda a derecha para mantener la bola en juego; la bola se desplaza por la cuadrícula superior, y los ladrillos/objetivos de recompensa en las filas superiores otorgan recompensa al ser golpeados, mientras que fallar la bola o golpear la pared inferior termina el episodio o conlleva una penalización. Confianza: 88%.
Qwen falló con el prompt de Freeway, lo cual no me sorprendió considerando que ese juego es más oscuro que los otros tres. Aquí está la transcripción: Qwen pensó que era "un juego de cuadrícula simplificado similar a Pac-Man: el agente se mueve en 4 direcciones".
Las trazas de razonamiento son divertidas de hojear, aunque casi incomprensibles. Aquí hay un ejemplo: ¿Qué pasa con el canal0 del agente? Vemos algunas filas grandes de canal0 cerca de la fila8 col7/8 y tal vez en la parte inferior. Listemos canal0 grande: línea436 input435 (fila8 col7 ch0) -2.107,1.169,0.513...; línea441 input440 (fila8 col8 ch0) -0.376,0.010,1.564,3.855...; línea445 input444 (fila8 col8 ch4) 0.142,0.491...; línea382? input381 ch0? Espera, línea382 input381: 381//5=76 (fila7 col6), ch1? 381%5=1? 76 * 5=380, ch1. Así que no. Canal0 grande tal vez solo en fila8 col7/8. ¿También en la fila superior? línea44 input43 ch3, línea49 ch3. Canal0 grande tal vez no muchos. La posición del agente podría estar cerca de la parte inferior derecha. Si el agente está típicamente en la parte inferior derecha.
Dicho esto, espero que un humano con suficiente experiencia, armado con un cuaderno y un lápiz, pueda llegar allí con suficiente esfuerzo. Es un artículo interesante, pero algunos de los comentarios más amplios que he visto al respecto no parecen estar justificados. No estoy listo para declarar que la era del código fuente ha terminado y que nuestro futuro involucra máquinas incomprensibles editando sus propios pesos de modelo de maneras incomprensibles.
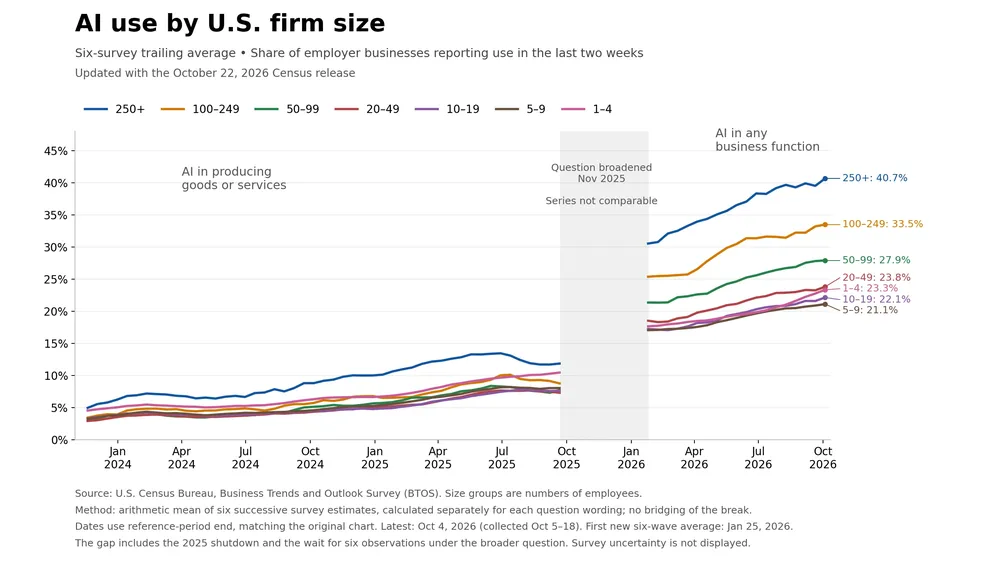
La Oficina del Censo de EE. UU. y la "Super Inteligencia" - 2 de noviembre de 2026. Este es un punto de inflexión en el desarrollo de juegos de vibra, que se destacó el 28 de octubre de 2026. Además, se presentó "Battle Drones", un juego de estrategia en tiempo real (RTS) con multijugador basado en audio, el 20 de octubre de 2026. También se anunció la llegada de Python 3.15, marcando la despedida de la versión 3.10 y la posibilidad de utilizar ahora la 3.11, el 12 de octubre de 2026.
Este contenido corresponde a "Qwen 3.8 27B en mi laptop puede interpretar pesos de modelo también" de Simon Willison, publicado el 3 de noviembre de 2026. Anteriormente, se discutió sobre la Oficina del Censo de EE. UU. y la "Super Inteligencia". En el informe mensual, se menciona que se puede patrocinar al autor por $10 al mes para recibir un resumen por correo electrónico de los desarrollos más importantes en LLM del mes. También se ofrece la opción de pagar para recibir menos información.
Fuente original: Simon Willison.


OpenAI aumenta los pagos por reportes de vulnerabilidades y lanza un nuevo programa de seguridad

OpenAI unifica ChatGPT y Work: un cambio que redefine el uso de inteligencia artificial

La calidad de los análisis en inteligencia artificial aún deja mucho que desear

La Oficina del Censo de EE. UU. y la “Super Inteligencia”

Anthropic amplía su marca de agua a nuevos modelos de Claude, pero deja un resquicio en dos versiones anteriores

Bitcoin alcanza los US$ 80.433, mientras Ethereum se sitúa en US$ 2.337,33

Bitcoin alcanza los US$ 78.009 y Ethereum se sitúa en US$ 2.270,83

Extensión manipulada de Claude Code estuvo disponible por 11 horas en la tienda de Cursor

Google lidera la carrera por los robotaxis y desplaza a Elon Musk