LFM3: la nueva generación de modelos de inteligencia artificial de Hugging Face

Hugging Face ha presentado LFM3, su nueva generación de Modelos de Fundamento Líquido (LFM), diseñada para ser la base de una inteligencia especializada. Este modelo integra texto, visión, audio, modalidades omni y de decisión en un solo sistema, con un rango de 2 mil millones de parámetros.
Inteligencia Artificial27 de octubre de 2026TechinfoTechinfo

LFM3 introduce cuatro cambios principales en comparación con la anterior familia LFM2. En primer lugar, ofrece más capacidad por parámetro: gracias a una nueva arquitectura tri-híbrida y un método de entrenamiento optimizado, el modelo LFM3-1.7B supera al LFM2.5-2.6B utilizando un 35% menos de parámetros. Esto significa que los desarrolladores pueden seleccionar el modelo adecuado para su modalidad, ajustarlo con sus propios datos en una sola GPU y desplegarlo donde su aplicación lo necesite.

En segundo lugar, LFM3 unifica todas las modalidades en una sola base. Se han entrenado seis modelos de clase 2B (texto, visión, audio, omni y de decisión) a partir del LFM3-1.7B-Base, incluyendo el primer modelo omni y la incorporación de entrada de video para el modelo de visión. Esto permite una mayor versatilidad en las aplicaciones que requieren múltiples tipos de datos.

Tercero, LFM3 está diseñado para funcionar en dispositivos de borde. El modelo de texto ocupa aproximadamente 1 GB a una precisión de 4 bits, mientras que nuevos codificadores de visión y audio desarrollados internamente aceleran el procesamiento. Además, el modelo de texto cuenta con una ventana de contexto de 256K, lo que permite que los agentes operen directamente en el dispositivo.

Por último, LFM3 está hecho para ser especializado. Cada modelo se puede ajustar en una sola GPU, lo que permite adaptarlo a los datos, la terminología y el entorno de despliegue específicos de cada usuario.

La construcción de un backbone más expresivo fue un objetivo clave en el desarrollo de LFM3. La versión anterior, LFM2, demostró que una combinación híbrida de convoluciones cortas y atención puede funcionar rápidamente en dispositivos sin sacrificar la calidad. Para LFM3, se utilizó una búsqueda de arquitectura con hardware en el bucle para rediseñar esta estructura, enfocándose en casos de uso que requieren más capacidad por parámetro y una inferencia rápida sobre contextos largos.

El modelo LFM3-1.7B-Base cuenta con 24 capas y presenta cuatro cambios principales. En primer lugar, se implementa una mezcla de capas tri-híbridas: 13 convoluciones cortas con compuerta, 5 capas de atención de ventana deslizante (SWA) con una ventana de 256 tokens, y 6 capas de atención global. Las convoluciones utilizan un tamaño de núcleo de 7, en comparación con 3 en LFM2.

Además, se ha incorporado una atención con compuerta a nivel de cabeza, donde una compuerta sigmoide ajusta la salida de cada cabeza, permitiendo que se desactive cuando no aporta información relevante. Esto ayuda a suprimir los valores atípicos de activación que pueden afectar la cuantización.

También se ha implementado una Rotación Parcial de Posición (RoPE) en las capas de atención global, donde solo se rota la mitad de mayor frecuencia de cada cabeza, asegurando que la otra mitad coincida en contenido sin importar la distancia. Las capas SWA mantienen la RoPE completa.

Finalmente, se ha introducido una normalización tipo sándwich, donde cada bloque normaliza tanto su entrada como su salida, asegurando que las activaciones se mantengan bien escaladas.

La recompensa se evidencia en contextos prolongados. Por cada parámetro, el modelo LFM3-1.7B iguala al LFM2-1.2B en indicaciones breves en dispositivos de borde, y con 8,000 tokens en contexto, es aproximadamente un 25% más rápido. El modelo LFM3-1.7B-Base fue preentrenado con 22 billones de tokens, utilizando el mismo vocabulario de 128,000 palabras que el LFM2.5-8B-A1B. Los últimos 3.5 billones de tokens corresponden a una etapa intermedia de entrenamiento sobre datos seleccionados, que incluye una mayor proporción de trazas de agentes y llamadas a herramientas, lo que también amplía la ventana de contexto a 256,000 tokens.

Todos los modelos LFM3 se derivan de LFM3-1.7B-Base. En lugar de utilizar un único modelo general de gran tamaño, se elige el que mejor se adapte a las entradas, se personaliza y se ejecuta en el dispositivo. Los modelos de visión y audio también incorporan dos nuevos codificadores desarrollados internamente: el codificador de visión combina convoluciones y atención, utilizando tres veces menos recursos computacionales que el codificador SigLIP2 de modelos anteriores de LFM VL. Nuestro codificador de 164 millones de parámetros iguala la precisión del codificador de visión Qwen3.5-2B, mientras que requiere 2.2 veces menos FLOPs (ambos medidos con la misma base de lenguaje LFM2.5-230M). Para el video, se incrusta cada par de fotogramas muestreados en una única sección temporal, reduciendo a la mitad la longitud de la secuencia temporal.

El codificador de audio y LiquidCodec: el codificador de audio combina atención en ventana deslizante y convoluciones cortas, siendo completamente causal, lo que permite que el modelo complete la información mientras se habla, con un tiempo hasta el primer token de tan solo 50 ms. LiquidCodec, nuestro nuevo tokenizador de audio, convierte los tokens generados en habla a una velocidad de aproximadamente 87 veces en tiempo real en un solo hilo de CPU en el Apple M4 Max y admite decodificación en streaming.

Cómo utilizar los modelos LFM3. Cada modelo se ejecuta en transformers. Los fragmentos a continuación provienen de las tarjetas de modelo, que también enumeran los otros motores de inferencia que cada modelo soporta.

LFM3-1.7B. Se recomienda utilizar LFM3-1.7B cuando se necesiten agentes locales, llamadas a herramientas, salidas estructuradas o una base para el ajuste fino específico de un dominio. Este modelo ha sido postentrenado para funcionar en arneses de agentes como Hermes Agent, Pi y OpenClaw. Supera a su predecesor, LFM2.5-2.6B, con un 35% menos de parámetros, y las mayores mejoras se observan en tareas de agentes: en WebArena-Verified, obtiene una puntuación de 38.42 frente a 3.02, y supera incluso a Qwen3.5-9B en tareas largas en navegadores y aplicaciones empresariales. Se pueden encontrar más detalles en la tarjeta del modelo LFM3-1.7B.

Para ejecutar LFM3-1.7B, es necesario instalar la última versión de transformers. Luego, se carga y ejecuta el modelo. Para la configuración del agente local, consulte la guía de arneses de agentes.

LFM3-VL-2B.

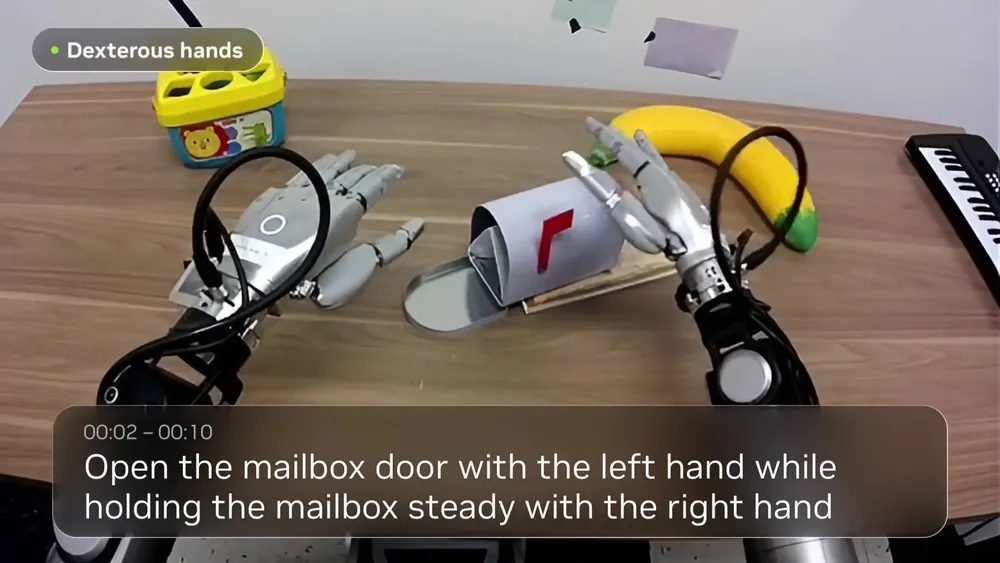
LFM3-VL-2B es la opción ideal cuando se requiere comprensión visual en dispositivos. Este es el primer modelo de visión LFM que acepta video como entrada; razona paso a paso antes de ofrecer una respuesta y es capaz de identificar objetos y deducir cómo están dispuestos, lo que representa una sólida base para la robótica. En comparación con LFM2.5-VL-3B, cuenta con menos parámetros (1.9B frente a 3.1B), pero mejora el promedio en 62 benchmarks de visión, pasando de 57.6 a 71.4, alcanzando niveles similares a los de Gemma 4 12B, un modelo más de seis veces más grande. Para más detalles, se puede consultar la tarjeta del modelo LFM3-VL-2B.

Para ejecutar LFM3-VL-2B, es necesario instalar transformers>=5.21.0 junto con sus dependencias de visión. En la tarjeta del modelo LFM3-VL-2B se pueden encontrar instrucciones sobre la llamada a herramientas, búsqueda de herramientas y la inferencia en dispositivos utilizando llama.cpp.

LFM3-Audio-2B es la opción recomendada para quienes necesiten chat de voz, reconocimiento de voz, síntesis de voz o traducción en 18 idiomas en una computadora portátil o dispositivo de borde. Este modelo acepta texto o audio como entrada y responde con texto, voz o ambos, además de poder convertir solicitudes habladas en llamadas a herramientas. En comparación con LFM2.5-Audio-1.5B, utiliza un nuevo codificador de audio y códec de voz desarrollado internamente, ofreciendo una calidad de sonido superior (UTMOSv2 3.83 frente a 3.22), e incorpora comprensión de audio, razonamiento de audio de propósito general y llamadas a herramientas. Para más detalles, se puede consultar la tarjeta del modelo LFM3-Audio-2B.

Para ejecutar LFM3-Audio-2B, se debe instalar transformers>=5.20.2 junto con sus dependencias de audio. El modelo y el procesador se pueden cargar directamente desde el Hugging Face Hub. Luego, se puede formular una pregunta en voz alta y recibir una respuesta tanto en texto como en voz. Para más información sobre reconocimiento de voz en tiempo real, síntesis de voz, comprensión de audio y llamadas a herramientas, se puede consultar la tarjeta del modelo LFM3-Audio-2B.

LFM3-Omni-2B.

LFM3-Omni-2B es el modelo ideal cuando se necesita un único modelo en el dispositivo que pueda ver, escuchar y responder, en lugar de depender de un modelo de reconocimiento de voz (ASR), un modelo de visión-lenguaje, un modelo de lenguaje de gran tamaño (LLM) y un modelo de texto a voz (TTS). Este modelo puede responder preguntas habladas sobre una imagen, analizar y escuchar un video simultáneamente, y convertir lo que ve y escucha en llamadas a herramientas. Se trata de nuestro primer modelo omni, que integra entrada de texto, visión y audio, así como salida tanto en texto como en voz. Además, mantiene las capacidades fundamentales de los modelos LFM3 independientes, que incluyen respuestas a preguntas visuales, reconocimiento de voz, síntesis de voz y seguimiento de instrucciones. Al igual que LFM3-Audio-2B, utiliza LiquidCodec, que convierte los tokens generados en voz más rápido que el tiempo real, permitiendo que las respuestas habladas se transmitan a medida que el modelo las genera. En cuanto a la comprensión de video audiovisual, supera a modelos de hasta 10.7 mil millones de parámetros, como Qwen2.5-Omni-7B, en pruebas como Daily-Omni, WorldSense y AV-SpeakerBench. Para más detalles, se puede consultar la tarjeta del modelo LFM3-Omni-2B.

Para ejecutar LFM3-Omni-2B, es necesario instalar transformers>=5.20.2 junto con sus dependencias de visión y audio. Luego, se puede realizar una pregunta sobre una foto de manera verbal. La tarjeta del modelo LFM3-Omni-2B proporciona información sobre la salida de voz, videos con su banda sonora y la llamada a herramientas.

Los modelos d1 son la opción a elegir cuando se requieren decisiones rápidas y estructuradas en lugar de texto generado. Se les puede proporcionar una situación (un ticket de soporte, una factura, una pantalla de aplicación, una foto o una nota de voz) y una lista de preguntas, y ellos responderán todas en una sola pasada, cada una con una probabilidad calibrada. Más allá de respuestas de sí/no, opciones y puntajes, ahora pueden señalar objetos, leer valores de documentos, estimar números con un rango y seleccionar todas las opciones que correspondan. Para más información, se pueden consultar las tarjetas de los modelos d1-2B y d1-omni-2B.

Entre los dos modelos d1, el d1-2B es la opción a elegir para texto, imágenes y video. Este modelo reemplaza al d1-3B con un tercio menos de parámetros y obtiene mejores resultados en las cuatro suites de decisiones, por ejemplo, 75.5 frente a 64.0 en ImajevBench. Por otro lado, el d1-omni-2B es la elección adecuada cuando las entradas incluyen audio. Si se formula una pregunta de manera verbal en lugar de por escrito, mantiene casi toda su precisión.

Para ejecutar d1-2B, es necesario instalar transformers>=5.19 junto con sus dependencias de visión. Luego, se puede cargar d1-2B y hacerle varias preguntas sobre un ticket de soporte en una sola pasada. Por brevedad, solo se incluye el ejemplo para d1-2B. Para clips de audio y preguntas habladas, se puede consultar la tarjeta del modelo d1-omni-2B.

Además, se puede ajustar finamente LFM3 para tareas específicas.

LFM3 está diseñado para ser especializado. Los modelos de frontera son potentes generalistas, pero no necesariamente son expertos en casos de uso específicos. LFM3 incorpora una capacidad adicional en un modelo pequeño y rápido, de modo que un breve ajuste fino puede transformarlo en un experto confiable en la tarea que se requiera, utilizando tus datos, terminología y herramientas. Gracias a su tamaño, puedes implementar el modelo ajustado donde se ejecute tu aplicación, desde dispositivos hasta infraestructura privada y la nube.

Cada modelo puede ser ajustado finamente en una sola GPU, y estos cuadernos de trabajo te guían a través de una tarea completa para modelos de texto, visión, audio y multimodales, desde la preparación de datos hasta la evaluación.

Por ejemplo, adaptamos LFM3-VL-2B en tres modelos robóticos complementarios para orquestación, navegación y manipulación. El orquestador opera un brazo robótico a través de llamadas a herramientas: identifica objetos señalando, los mide con herramientas de profundidad, invoca planificadores de movimiento y verifica resultados en imágenes de cámara posteriores. El navegador sigue descripciones de rutas utilizando observaciones RGB recientes, prediciendo objetivos espaciales y una trayectoria de puntos de paso en solo cinco tokens. La manipulación VLA mapea imágenes, lenguaje y estado del robot a segmentos de acciones continuas de ocho pasos en una sola pasada hacia adelante. Entrenado conjuntamente en 15 encarnaciones, el VLA logra un 96.2% de éxito promedio en los cuatro conjuntos LIBERO y un 45.7% en tareas de mesa RoboCasa-GR1, generando segmentos de acción en menos de 50 ms en un Jetson AGX Orin con TensorRT FP16. Estos resultados destacan a LFM3-VL-2B como una base compacta para la robótica, abarcando desde la planificación de alto nivel hasta el control de bajo nivel con generación de acciones en tiempo real en hardware embebido.

Todos los modelos LFM3 son de peso abierto y están disponibles en Hugging Face hoy: puedes descargar la colección LFM3 en Hugging Face, que incluye LFM3-1.7B-Base para tu propio post-entrenamiento. También puedes adaptar LFM3 a tu tarea con nuestros cuadernos de ajuste fino. Además, sigue nuestra guía sobre cómo ejecutar un agente local, como OpenClaw, Hermes Agent y Pi. Estamos ansiosos por ver lo que construyas.

Para participar de la discusión o dejar un comentario, es necesario registrarse o iniciar sesión en la plataforma.

Esta opción permite a los usuarios interactuar y compartir sus opiniones sobre el contenido presentado.

Fuente original: Hugging Face Blog.

Te puede interesar
Lo más visto