Google lanza dos nuevos sistemas en su línea de chips de inteligencia artificial TPU

Google ha presentado dos nuevos sistemas en su octava generación de chips de inteligencia artificial, el TPU 8tx y el TPU 8i Max, marcando un hito al haber enviado cuatro variantes de TPU en un solo año. Estos desarrollos buscan fortalecer su posición en el mercado frente a Nvidia.
Inteligencia Artificial09 de noviembre de 2026TechinfoTechinfo

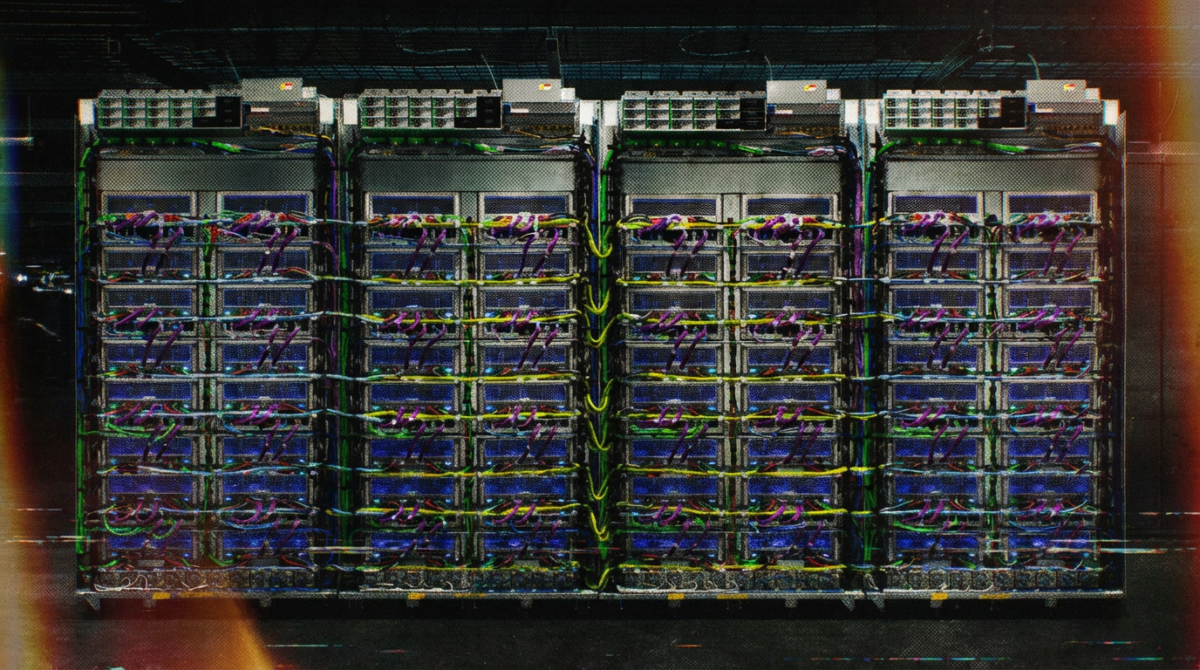
Google ha añadido dos nuevos sistemas a su línea de aceleradores de inteligencia artificial de octava generación: el TPU 8tx, orientado a la computación confidencial, y el TPU 8i Max, diseñado para cargas de trabajo que requieren gran cantidad de memoria. Con estas incorporaciones, la compañía afirma que ha enviado cuatro sistemas TPU en un solo año por primera vez. Ambos nuevos modelos están construidos sobre silicio existente, lo que significa que Google no está introduciendo una nueva generación de chips, sino configuraciones de sistema diferentes: empaques, redes y configuraciones de memoria distintas alrededor del mismo procesador. Esta estrategia modular se presenta como una elección de diseño deliberada que permite a la empresa ofrecer nuevas variantes de hardware en meses en lugar de años.

El TPU 8tx está dirigido a empresas y agencias gubernamentales que manejan datos confidenciales. Generalmente, los datos se cifran durante el almacenamiento y la transmisión, pero deben ser descifrados en la memoria una vez que un procesador los utiliza. El TPU 8tx busca cerrar esa brecha. Según Google, los datos y los pesos del modelo permanecen protegidos y aislados incluso durante su uso activo. Nvidia ya ofrece una función comparable para sus GPUs a través de su arquitectura de computación confidencial. Este sistema utiliza la misma red Boardfly de baja latencia que Google desarrolló para inferencias en tiempo real y se espera que ofrezca hasta el doble de reducción de latencia en comparación con el TPU 8t. Google sostiene que las empresas pueden utilizar un solo sistema para afinar modelos, destilar grandes modelos en versiones más pequeñas y entrenar agentes de inteligencia artificial mediante aprendizaje por refuerzo, todo sin mover datos sensibles entre diferentes clústeres.

Por otro lado, el TPU 8i Max duplica la potencia de cálculo en el mismo rack al combinar dos chips en un solo paquete. Esta configuración permite a los desarrolladores y empresas manejar aplicaciones que demandan un alto rendimiento y grandes capacidades de memoria. Con estas innovaciones, Google busca facilitar el acceso a su hardware a clientes externos, además de reducir las barreras para los desarrolladores a través de herramientas de software como TorchTPU, que están diseñadas para optimizar la inferencia de modelos en el día a día.

El TPU 8i Max aborda un problema diferente: el cuello de botella de la memoria. Cuando los agentes de inteligencia artificial trabajan simultáneamente en grandes bases de código o en horas de video, el ancho de banda de memoria se convierte en un punto crítico. Google ha solucionado esto al colocar dos chips TPU 8i en un solo paquete.

El resultado es el doble de potencia de cálculo, el doble de memoria y el doble de ancho de banda de memoria en el mismo formato de rack, lo que significa un rendimiento significativamente mayor por metro cuadrado en el espacio del centro de datos.

Más allá del hardware, Google está trabajando para facilitar el uso de los TPU. La compañía ha lanzado TorchTPU como código abierto, por lo que el código de PyTorch debería funcionar en TPU con cambios mínimos. También se admiten marcos de inferencia populares como vLLM y SGLang.

La expansión es una respuesta directa al cambio estratégico de Google, que ha pasado de tratar los TPU como una herramienta puramente interna a comercializarlos como una plataforma competitiva para clientes externos. Actualmente, la compañía cuenta con casi 100 clientes externos de TPU.

Una tendencia de mercado más amplia está impulsando este impulso. A medida que las aplicaciones de inteligencia artificial se expanden, el enfoque está cambiando de las costosas ejecuciones de entrenamiento a la inferencia, es decir, la operación diaria de los modelos. Los chips especializados como los TPU pueden aprovechar sus fortalezas precisamente en este ámbito. Por esta razón, Amazon, Microsoft y OpenAI también están desarrollando sus propios aceleradores.

Nvidia ha respondido a esta competencia fortaleciendo su propia oferta de inferencia a través de su adquisición y acuerdo de licencia con Groq.

Fuente original: The Decoder.

Te puede interesar
portada_techinfo

Apple planea transformar a Siri en un asistente más autónomo

Techinfo
Inteligencia Artificial08 de noviembre de 2026
Apple está trabajando en una evolución significativa de Siri, su asistente virtual, que podría permitirle actuar de manera más independiente a partir del próximo año. Este cambio podría redefinir la interacción de los usuarios con sus dispositivos y fortalecer la competencia de Apple frente a otros asistentes virtuales.
Lo más visto
portada_techinfo

La Comisión Europea critica el algoritmo de TikTok y exige cambios

Techinfo
Actualidad07 de noviembre de 2026
La Comisión Europea ha realizado una evaluación preliminar del sistema de recomendación de TikTok, señalando que incumple la Ley de Servicios Digitales debido a los riesgos que presenta para la salud mental de los usuarios. Este análisis pone en cuestión el funcionamiento del algoritmo que determina el contenido que se muestra en la pestaña «Para ti».